


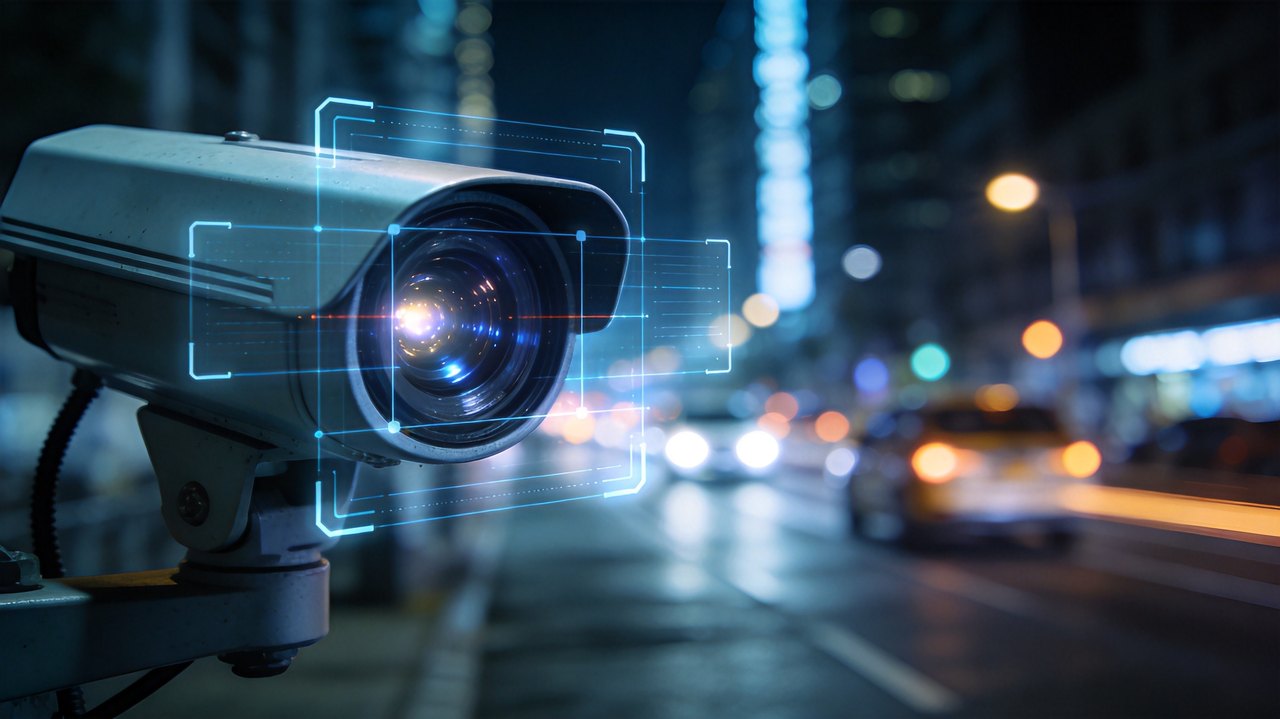
2026 世界计算大会 11 月 19 日到 21 日在长沙办,国科微第一次独立设展,主题只有一句话:构建端侧 AI 芯引擎。展台上摆了一个很说明问题的对比——关灯、关门,暗室伸手不见五指,传统摄像头拍出来是一片灰白噪点,搭载自研 AI 视觉芯片的设备却能还原出接近白昼的亮度和色彩。

摄像头从「看得清」到「看得懂」,只是表象。真正值得拆的是它背后那颗芯片:自研 NPU 已经演进到第四代,也就是 GKNPU 4.0,算力规划从 0.5T 一路铺到 64T、128T。这个跨度放在端侧设备上意味着什么,比发布会上的数字更值得说清楚。
一、机器人为什么不能一直等云端
具身机器人在真实环境里完成连续移动、抓取、放置,需要实时掌握三类空间信息:自身的位姿、周围环境的结构、以及行动目标在空间里的位置。从移动接近、近场抓取到转向放置,每个阶段都要持续融合多视角观测,并且不断在线更新位姿、目标位置和环境表示。
一旦位姿估计、深度估计或者视角关联出现偏差,后果不是画面糊一点,而是地图重影、结构错位,直接影响到避障和抓取可靠性。这种链条对延迟极其敏感——云端往返几百毫秒,机器人可能已经撞上去了。
再加上两个现实约束:断网环境要能工作,视频流全量上传的带宽成本也扛不住。所以关键决策很难完全交给云端,端侧必须自己扛下一部分推理。

二、端侧 NPU 真正的难点,不是算力数字
端侧设备的算力、内存、带宽、功耗预算都很紧。难的地方在于,同一块芯片上要并行跑三类完全不同的负载:多路视觉感知、交互大模型推理、三维空间重建。
这三类负载对精度的要求正好相反。大模型推理想省内存省带宽,权重压到 4bit 最划算;空间几何重建偏偏不能省,位姿和深度的误差会随时间累积,必须保持 FP16;视觉前处理又追求吞吐,INT8 稠密算力最合适。
所以端侧 NPU 的竞争点,早就不是「多少 TOPS」这种单点数字,而是能不能在同一套算子体系里同时支持不同精度,并且把内存墙和带宽瓶颈压下去。
三、GKNPU 4.0 改的是架构,不是参数
国科微前几代 NPU 主要面向 CNN,属于控制流架构。第四代转向数据流架构,核心变化是面向注意力计算做了增强型脉动阵列设计,扩展矩阵和向量计算能力,压缩数据搬运路径和流水线开销,增强片上闭环计算。
翻成大白话:以前算一步要来回搬数据,现在尽量让数据在片内流动起来,少去访问外部存储。它原生支持 FlashAttention 这类推理加速技术——分块计算、在线 Softmax、异步流水,把中间结果留在片上缓存,减少对外部带宽的依赖。
这件事对端侧特别重要。端侧没有数据中心那种带宽,内存墙往往比算力墙更早撞上。谁能在架构层面少搬数据,谁的实际推理效率就更高。

四、一颗芯片里跑三种精度,是怎么分工的
国科微给出的方案叫「交互与几何同时在线」,同一套 NPU 算子原生支持不同精度组合:
- 交互大模型推理:权重 4bit、激活 FP16、KV 缓存 INT8,KV 缓存配合分页管理,缓解长上下文和多路并发带来的内存与带宽压力;
- 空间几何重建:全程保持 FP16,包括中间特征和输出,避免位姿、深度等几何信息误差随时间累积;
- 视觉前处理:运行在 INT8 稠密精度,保障多路视觉接入的吞吐。
这套分工看着朴素,实际是端侧部署里最容易踩坑的地方。很多方案在跑单路摄像头时表现不错,一上多路、再叠一个 VLA 模型,就开始掉帧或者内存溢出。原因往往不是算力不够,而是精度策略和内存管理没做分层。
五、GK6950 和流式 SLAM:所见即所建
面向人机交互和具身智能,国科微规划了 GK6950 系列,明年正式推出。它基于新一代端侧 AI NPU 架构,提供 10 TOPS 稠密 INT8 算力,支持 INT4、INT8、INT16、FP16 混合精度,用统一架构覆盖视觉感知、Transformer 与大模型推理、物理 AI 推理。
配套的 GK-VGGT-SLAM 是轻量级流式空间推理算法。传统三维重建大多走「先采集、后处理」的联合推理,机器人得等一段视频录完才能建图;GK-VGGT-SLAM 用纯自回归的流式因果重建,每次推理只使用当前和已获得的历史观测,不访问未来信息,在采集过程中实时还原场景三维结构。
一句话概括:机器人一边走,一边建图,不用停下来等后处理。这解决的正是具身智能落地时最头疼的「换个场景就失灵」。
六、给做端侧部署的人三条选型建议
第一,别只看 TOPS。要看精度组合是否原生支持,混合精度跑起来是硬件加速还是靠软件降级,差别很大。
第二,看工具链。国科微这一代配套 GKToolchain 3.0,重点在硬件感知编译、自动分块、自动向量化、异步数据读写和计算流水编排。工具链成熟度直接决定模型从「能跑」到「跑得快」要花多少人力。
第三,看生态对接。GK7206V1 已经和通义千问做深度融合,万物检测算法加大模型推理形成闭环;基于 GK6323 的电视伴学机打通了「端侧 AI 芯片 + 鸿蒙 + DeepSeek」的全链路国产方案。能不能直接复用现成模型,比参数表更能省时间。
七、产业侧的一个信号
2026 年前三季度,国科微营收 23.76 亿元,同比增长 102.71%;归母净利润 4.25 亿元,同比增长 5640.94%。单看第三季度,营收 9.98 亿元,同比增长 132%,智慧视觉 SoC 毛利率约 58%。公司还披露了不超过 50.6 亿元的定增预案,主要投向 AI 视觉处理芯片、媒体交互 AI 芯片和端侧 AI 芯片的研发产业化。
这些数字说明一件事:端侧 AI 不是概念阶段的叙事,是已经在批量出货的生意。算力从 0.5T 铺到 128T,产品线从安防视觉延伸到 AI 眼镜、扫地机器人、割草机、无人机、AIPC,路线是清晰的。
写在最后
端侧 AI 的竞争重心,正在从「谁的算力高」转向「谁能在功耗、内存、延迟的三重约束下把模型真正跑起来」。这个转向对做算法部署和硬件选型的人,比对看财报的人更重要——因为前者决定产品能不能落地,后者只决定股价怎么走。
如果你正在做端侧推理的部署,可以先问自己一个问题:你的模型,在断网、只有几瓦功耗预算的设备上,还能跑出可用的帧率吗?这个问题的答案,比任何一份参数表都更接近真相。







暂无评论内容